- Почему отказоустойчивость критична для VDI
- Ключевые метрики отказоустойчивости
- Слабые места типовой VDI-инфраструктуры
- Архитектурные принципы отказоустойчивого VDI
- Кластеризация и высокая доступность гипервизоров
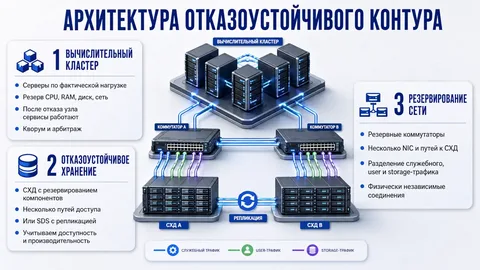
- Отказоустойчивые системы хранения
- Сетевая отказоустойчивость
- Технологии и платформы для отказоустойчивого VDI
- Гиперконвергентная инфраструктура для VDI
- Георезервирование и катастрофоустойчивость
- Резервное копирование и восстановление
- Практика внедрения и типичные ошибки
- Мониторинг и проактивное управление
- Экономика отказоустойчивости
- Будущее отказоустойчивого VDI
- Искусственный интеллект и автоматизация
- Облачные и гибридные модели
Решения для отказоустойчивой инфраструктуры VDI — это комплекс технологий и архитектурных подходов, обеспечивающих бесперебойную работу виртуальных рабочих столов даже при сбоях отдельных компонентов. Компания, специализирующаяся на построении инфраструктуры виртуальных десктопов, предлагает проверенные сценарии отказоустойчивости: кластеризацию гипервизоров, репликацию данных, балансировку нагрузки и георезервирование. Обычно решения для отказоустойчивой инфраструктуры VDI позволяют сотрудникам продолжать работу при отказе сервера, дискового массива или сетевого узла, а бизнесу — избегать простоев и финансовых потерь.
Виртуализация рабочих мест давно перестала быть экзотикой: банки, госсектор, промышленность, ритейл и телеком активно переводят сотрудников на VDI. Однако чем критичнее задачи, тем выше требования к надёжности. Простой виртуального рабочего стола в call-центре, операционной или проектной группе обходится дорого. Именно поэтому решения для отказоустойчивой инфраструктуры VDI проектируются с учётом резервирования на всех уровнях — от серверов и систем хранения до сети и гипервизора.
Почему отказоустойчивость критична для VDI
VDI концентрирует вычислительные ресурсы в дата-центре, поэтому отказ одного компонента может затронуть сотни и тысячи пользователей одновременно. В отличие от распределённых физических ПК, где поломка затрагивает одного сотрудника, сбой в VDI-инфраструктуре парализует целые подразделения. Решения для отказоустойчивой инфраструктуры VDI минимизируют этот риск за счёт дублирования и автоматического переключения.
Кроме того, VDI часто используется для удалённой работы и обслуживания критичных бизнес-процессов. Если виртуальный рабочий стол недоступен, сотрудник не может войти в CRM, ERP, медицинскую или финансовую систему. Простой измеряется не только часами, но и репутационными потерями, штрафами и упущенной выгодой.
- высокая концентрация пользователей на единой инфраструктуре;
- критичность бизнес-приложений, работающих через VDI;
- требования SLA по доступности 99,9% и выше;
- риск потери данных при сбое систем хранения;
- необходимость поддержки удалённых сотрудников;
- финансовые и репутационные последствия простоев.
Ключевые метрики отказоустойчивости
При проектировании отказоустойчивой VDI-инфраструктуры оперируют несколькими ключевыми метриками. RTO (Recovery Time Objective) определяет допустимое время восстановления после сбоя. RPO (Recovery Point Objective) — допустимый объём потерянных данных. Решения для отказоустойчивой инфраструктуры VDI стремятся к RTO, близкому к нулю, и RPO, равному нулю, за счёт синхронной репликации.
Доступность измеряется в процентах: 99,9% — это около 8,8 часов простоя в год, 99,99% — менее часа, 99,999% — минуты. Для критичных VDI-сценариев целевой показатель — «четыре девятки» и выше. Компания помогает рассчитать метрики под конкретный бизнес-кейс.
| Метрика | Значение | Влияние на архитектуру |
|---|---|---|
| RTO | 0–15 минут | автоматическое переключение |
| RPO | 0 | синхронная репликация |
| Доступность | 99,99%+ | резервирование всех уровней |
| Масштабируемость | горизонтальная | кластеры и балансировка |
Слабые места типовой VDI-инфраструктуры
Типовая VDI-инфраструктура включает серверы виртуализации, систему хранения, сеть, брокер подключений и гипервизор. Каждый из этих элементов — потенциальная точка отказа. Решения для отказоустойчивой инфраструктуры VDI устраняют единые точки отказа (SPOF) путём дублирования и кластеризации.
Наиболее уязвимы системы хранения: отказ массива приводит к недоступности всех виртуальных машин. Сетевые сбои нарушают связь между компонентами. Отказ гипервизора останавливает работу всех ВМ на хосте. Грамотная архитектура предусматривает резервирование каждого уровня.
Архитектурные принципы отказоустойчивого VDI
Построение отказоустойчивой VDI-инфраструктуры базируется на нескольких принципах: отсутствие единых точек отказа, избыточность, автоматическое восстановление и географическое распределение. Решения для отказоустойчивой инфраструктуры VDI реализуются через кластеры гипервизоров, репликацию хранилищ, резервные каналы связи и балансировщики нагрузки.
Ключевой подход — N+1 или N+2 резервирование, когда один или два компонента могут выйти из строя без потери доступности. Для критичных систем применяется актив-актив конфигурация, при которой нагрузка распределяется между двумя и более площадками.
- кластеризация гипервизоров с автоматическим перезапуском ВМ;
- синхронная и асинхронная репликация хранилищ;
- резервные сетевые каналы и балансировка трафика;
- георезервирование между дата-центрами;
- автоматический мониторинг и самовосстановление;
- резервное копирование и снапшоты.
Кластеризация и высокая доступность гипервизоров
Кластер гипервизоров объединяет несколько физических серверов в единый пул ресурсов. Если один хост выходит из строя, его виртуальные машины автоматически перезапускаются на других узлах. Решения для отказоустойчивой инфраструктуры VDI используют кластеры с функциями HA (High Availability) и DRS (Distributed Resource Scheduler) для балансировки нагрузки.
Современные платформы поддерживают «нулевой простой» за счёт vMotion и live migration: ВМ перемещаются между хостами без отключения пользователей. Это позволяет проводить обслуживание оборудования без остановки работы сотрудников.
Отказоустойчивые системы хранения
Хранилище — сердце VDI. Для отказоустойчивости применяются RAID-массивы, Erasure Coding, репликация между узлами и гиперконвергентные решения. Решения для отказоустойчивой инфраструктуры VDI на базе HCI (Hyperconverged Infrastructure) распределяют данные по нескольким узлам, обеспечивая доступность при отказе одного или двух дисков и даже целого сервера.
Синхронная репликация между площадками гарантирует RPO=0: данные записываются одновременно в два хранилища. При аварии на основной площадке система переключается на резервную без потери информации.
| Технология | Уровень защиты | Особенности |
|---|---|---|
| RAID 10 | отказ 1–2 дисков | высокая производительность |
| Erasure Coding | отказ нескольких узлов | экономия ёмкости |
| Синхронная репликация | отказ площадки | RPO = 0 |
| HCI-кластер | отказ узла | масштабируемость |
Сетевая отказоустойчивость
Сеть связывает все компоненты VDI, поэтому её резервирование критично. Используются агрегированные каналы (LACP), протоколы STP и VRRP, резервные маршруты и балансировщики. Решения для отказоустойчивой инфраструктуры VDI предусматривают дублирование коммутаторов, маршрутизаторов и каналов связи между площадками.
Для удалённых сотрудников важна доступность через интернет и VPN. Резервные провайдеры и SD-WAN позволяют переключать трафик при сбое основного канала, сохраняя подключение к виртуальным рабочим столам.
«Отказоустойчивость VDI — это не одна технология, а система взаимосвязанных решений. Только комплексный подход даёт реальную бесперебойность», — подчёркивают архитекторы компании.
Технологии и платформы для отказоустойчивого VDI
Современный рынок предлагает широкий спектр платформ и инструментов для построения отказоустойчивого VDI. Среди них VMware Horizon, Citrix Virtual Apps and Desktops, Microsoft Azure Virtual Desktop, а также решения на базе KVM и Proxmox. Решения для отказоустойчивой инфраструктуры VDI могут строиться как на проприетарных, так и на открытых технологиях.
Выбор платформы зависит от масштаба, бюджета, требований к безопасности и наличия компетенций у ИТ-команды. Компания помогает подобрать оптимальный стек и спроектировать архитектуру под конкретные задачи.
- VMware Horizon с vSphere HA и vSAN;
- Citrix Virtual Apps and Desktops с NetScaler;
- Microsoft Azure Virtual Desktop с зональным резервированием;
- гиперконвергентные платформы Nutanix, vSAN, S2D;
- решения на базе Proxmox и KVM;
- системы резервного копирования Veeam, Commvault.
Гиперконвергентная инфраструктура для VDI
HCI объединяет вычисления, хранение и сеть в едином кластере, что упрощает масштабирование и повышает отказоустойчивость. Решения для отказоустойчивой инфраструктуры VDI на базе HCI обеспечивают автоматическое восстановление данных и ВМ при отказе узла. Это оптимальный выбор для средних и крупных VDI-развёртываний.
HCI-платформы поддерживают политики хранения, определяющие уровень резервирования для каждой ВМ. Критичные рабочие столы получают тройную репликацию, менее важные — двойную или Erasure Coding.
Георезервирование и катастрофоустойчивость
Для защиты от аварий на уровне дата-центра применяется георезервирование. Два или более ЦОД соединяются высокоскоростными каналами, данные реплицируются синхронно или асинхронно. Решения для отказоустойчивой инфраструктуры VDI с георезервированием позволяют переключить всех пользователей на резервную площадку за минуты.
Актив-актив конфигурация распределяет нагрузку между площадками, обеспечивая балансировку и мгновенное переключение. Актив-пассив — более экономичный вариант, при котором резервная площадка включается только при аварии.
- Определите критичные бизнес-процессы и требования к RTO/RPO.
- Выберите платформу виртуализации и тип хранилища.
- Спроектируйте кластеры с резервированием N+1 или N+2.
- Настройте репликацию данных между узлами и площадками.
- Обеспечьте резервные сетевые каналы и балансировку.
- Внедрите мониторинг, бэкапы и регулярные учения.
Резервное копирование и восстановление
Даже самая отказоустойчивая система нуждается в бэкапах. Резервное копирование защищает от логических ошибок, вирусов-шифровальщиков и случайных удалений. Решения для отказоустойчивой инфраструктуры VDI включают автоматические бэкапы профилей, данных и конфигураций ВМ.
Современные системы резервного копирования поддерживают мгновенное восстановление, дедупликацию и репликацию в облако. Это сокращает время восстановления и снижает нагрузку на основную инфраструктуру.
«Мы протестировали переключение на резервный ЦОД: 1200 виртуальных рабочих столов переехали за 7 минут без потери данных. Пользователи даже не заметили сбоя», — делится опытом ИТ-директор финансовой организации.
Практика внедрения и типичные ошибки
Внедрение отказоустойчивого VDI требует тщательного планирования и тестирования. Ошибки на этапе проектирования приводят к тому, что инфраструктура формально отказоустойчива, но не выдерживает реальных сбоев. Решения для отказоустойчивой инфраструктуры VDI должны проверяться учениями и стресс-тестами.
Компания сопровождает проекты на всех этапах: аудит текущей инфраструктуры, проектирование, пилот, внедрение, обучение персонала и поддержка. Такой подход гарантирует, что система будет работать надёжно и предсказуемо.
- недостаточное тестирование сценариев отказа;
- экономия на резервных каналах и оборудовании;
- отсутствие мониторинга и автоматического оповещения;
- игнорирование обновлений и патчей;
- нехватка компетенций у ИТ-команды;
- отсутствие регламентов восстановления.
Мониторинг и проактивное управление
Отказоустойчивость невозможна без постоянного мониторинга. Системы собирают метрики производительности, доступности и ошибок, оповещают администраторов о проблемах до того, как они станут критичными. Решения для отказоустойчивой инфраструктуры VDI включают проактивную диагностику и предиктивную аналитику.
Автоматизация управления позволяет реагировать на инциденты без участия человека: перезапуск служб, миграция ВМ, переключение на резервный узел. Это сокращает RTO и снижает нагрузку на ИТ-персонал.
Экономика отказоустойчивости
Построение отказоустойчивой инфраструктуры требует инвестиций, но они окупаются за счёт предотвращённых простоев. Час простоя VDI в крупной компании может стоить миллионы рублей. Решения для отказоустойчивой инфраструктуры VDI снижают эти риски и обеспечивают предсказуемость ИТ-расходов.
Компания помогает рассчитать совокупную стоимость владения (TCO) и обосновать бюджет перед руководством. Гибкие схемы лицензирования и поэтапное внедрение делают проект доступным для организаций разного масштаба.
«Инвестиции в отказоустойчивость — это страховка от катастроф. Мы потратили на резервирование меньше, чем потеряли бы за один день простоя», — отмечает руководитель ИТ-департамента производственной компании.
Будущее отказоустойчивого VDI
Технологии VDI продолжают развиваться. На смену классическим трёхуровневым архитектурам приходят гиперконвергентные и облачные решения, а отказоустойчивость закладывается на уровне платформы. Решения для отказоустойчивой инфраструктуры VDI всё чаще используют искусственный интеллект для прогнозирования сбоев и автоматического восстановления.
Облачные VDI-сервисы предлагают встроенную отказоустойчивость за счёт распределения по зонам доступности. Гибридные модели позволяют комбинировать локальные и облачные ресурсы, обеспечивая баланс между стоимостью и надёжностью.
Искусственный интеллект и автоматизация
AI-алгоритмы анализируют телеметрию и предсказывают отказы оборудования до их возникновения. Решения для отказоустойчивой инфраструктуры VDI с ИИ способны автоматически мигрировать нагрузку, оптимизировать ресурсы и предотвращать инциденты. Это снижает зависимость от человеческого фактора и ускоряет реакцию на проблемы.
Автоматизация развёртывания и управления (IaC, GitOps) делает инфраструктуру воспроизводимой и предсказуемой. Изменения тестируются в изолированных средах и применяются без риска для продакшена.
Облачные и гибридные модели
Облачные VDI-платформы обеспечивают отказоустойчивость на уровне провайдера: зоны доступности, регионы, автоматическое масштабирование. Решения для отказоустойчивой инфраструктуры VDI в облаке снижают капитальные затраты и упрощают управление. Гибридные модели позволяют держать критичные данные локально, а пиковые нагрузки выносить в облако.
Компания помогает выбрать оптимальную модель: полностью локальную, облачную или гибридную, с учётом требований безопасности, бюджета и ИТ-стратегии.
«Будущее за гибридными решениями: локальная инфраструктура для чувствительных данных, облако — для масштабирования и резервирования. Это даёт максимальную гибкость и надёжность», — подчёркивают эксперты компании.
Таким образом, решения для отказоустойчивой инфраструктуры VDI — это фундамент бесперебойной работы современных организаций. Компания предлагает комплексный подход: аудит, проектирование, внедрение, мониторинг и поддержку. Резервирование на всех уровнях, георезервирование, автоматизация и проактивное управление обеспечивают доступность виртуальных рабочих столов даже в самых сложных условиях.